asc_copy_l12l0a(NPU架构版本3510,3D矩阵搬运)
产品支持情况
- Ascend 950PR&950DT系列产品:支持
- Atlas A3系列产品:不支持
- Atlas A2系列产品:不支持
- Atlas 200I/500 A2推理产品:不支持
- Atlas推理系列产品AI Core:不支持
- Atlas推理系列产品Vector Core:不支持
- Atlas训练系列产品:不支持
功能说明
头文件路径为:"c_api/cube_datamove/cube_datamove.h"。
3D卷积数据搬运是用于将NC1HWC0格式的Feature Map完成Image to Column展开,然后再从展开后的二维矩阵中选取指定数据块搬入对应内存位置。见图1。
搬运过程中是以512字节的数据分形为单位进行搬运的,此接口也可以用于普通矩阵计算所需的2D格式数据的搬运。如何使用此接口进行2D格式数据的搬运可以参考关键特性说明。支持从L1 Buffer到L0A Buffer的数据搬运。

3D img2col搬运模式下,Feature Map的属性描述(fm_w、fm_h及四周padding)需通过asc_set_l13d_fmatrix预先配置,填充值与填充模式需通过asc_set_l12l0a_3d_padding预先配置;如需使用repeat模式,repeat方向、次数与步长需通过asc_set_l13d_rpt预先配置。
本接口仅在AIC上执行有效。
搬入前的数据排布参见关键分形格式详解;地址对齐与搬运粒度要求参见矩阵计算输入搬运约束,并结合本接口的参数和约束说明使用。
函数原型
3D搬运模式
__aicore__ inline void asc_copy_l12l0a(__ca__ <dtype>* dst,
                                       __cbuf__ <dtype>* src,
                                       uint16_t k_extension,
                                       uint16_t m_extension,
                                       uint16_t k_start_pt,
                                       uint16_t m_start_pt,
                                       uint8_t stride_w,
                                       uint8_t stride_h,
                                       uint8_t filter_w,
                                       uint8_t filter_h,
                                       uint8_t dilation_filter_w,
                                       uint8_t dilation_filter_h,
                                       bool filter_size_w,
                                       bool filter_size_h,
                                       bool transpose,
                                       bool f_matrix_ctrl,
                                       uint16_t channel_size)
dtype支持数据类型
dtype取值为:int8_t、uint8_t、hifloat8_t、fp8_e5m2_t、fp8_e4m3fn_t、int16_t、uint16_t、half、bfloat16_t、int32_t、uint32_t、float。
函数原型典型示例
// 示例:half类型的3D搬运。
__aicore__ inline void asc_copy_l12l0a(__ca__ half* dst,
                                       __cbuf__ half* src,
                                       uint16_t k_extension,
                                       uint16_t m_extension,
                                       uint16_t k_start_pt,
                                       uint16_t m_start_pt,
                                       uint8_t stride_w,
                                       uint8_t stride_h,
                                       uint8_t filter_w,
                                       uint8_t filter_h,
                                       uint8_t dilation_filter_w,
                                       uint8_t dilation_filter_h,
                                       bool filter_size_w,
                                       bool filter_size_h,
                                       bool transpose,
                                       bool f_matrix_ctrl,
                                       uint16_t channel_size)
参数说明
表1 参数说明
| 参数名 | 输入/输出 | 描述 |
|---|---|---|
dst | 输出 | 目的操作数,存储位置为L0A Buffer。目的地址需512字节对齐。 |
src | 输入 | 源操作数,存储位置为L1 Buffer。源地址需32字节对齐。 |
k_extension | 输入 | 目的操作数width维度的传输长度,如果不覆盖最右侧的分形,对于b32类型,应为8的倍数,对于b16类型,应为16的倍数,对于b8类型,应为32的倍数;覆盖的情况则任何数据类型都无倍数要求。取值范围:[1, 65535]。 |
m_extension | 输入 | 目的操作数height维度的传输长度,如果不覆盖最下侧的分形,对于b8、b16类型,应为16的倍数,b32类型无要求;覆盖的情况则任何数据类型都无倍数要求。取值范围:[0, 65535]。 |
k_start_pt | 输入 | 目的操作数width维度的起点,对于b32类型,应为8的倍数,对于b16类型,应为16的倍数,对于b8类型,应为32的倍数;取值范围:[0, 65535]。 |
m_start_pt | 输入 | 目的操作数height维度的起点,取值范围:[0, 32767]。 |
stride_w | 输入 | 卷积核在源操作数width维度滑动的步长,取值范围:[1, 63]。 |
stride_h | 输入 | 卷积核在源操作数height维度滑动的步长,取值范围:[1, 63]。 |
filter_w | 输入 | 卷积核width,取值范围:[1, 255]。 |
filter_h | 输入 | 卷积核height,取值范围:[1, 255]。 |
dilation_filter_w | 输入 | 卷积核width膨胀系数,取值范围:[1, 255]。 |
dilation_filter_h | 输入 | 卷积核height膨胀系数,取值范围:[1, 255]。 |
filter_size_w | 输入 | 是否在filter_w的基础上将卷积核width增加256个元素。• true:增加;• false:不增加。 |
filter_size_h | 输入 | 是否在filter_h的基础上将卷积核height增加256个元素。• true:增加;• false:不增加。 |
transpose | 输入 | 是否启用转置功能,对整个目标矩阵进行转置。 • false:不开启转置;• true:开启转置。 |
f_matrix_ctrl | 输入 | 3D数据搬运Feature Map的属性描述寄存器组选择位,一般设置为false。• true:从右矩阵中获取Feature Map的属性描述,配合asc_set_l13d_fmatrix_b、asc_set_l12l0b_3d_padding、asc_set_l13d_rpt_b使用;• false:从左矩阵中获取FeatureMap的属性描述,配合asc_set_l13d_fmatrix、asc_set_l12l0a_3d_padding、asc_set_l13d_rpt使用。 |
channel_size | 输入 | 源操作数的通道数N。 对于b32类型, channel_size除8的余数应当为0或4,最大值可取为65532。对于b16类型, channel_size除16的余数应当为0,4或8,最大值可取为65528。对于b8类型, channel_size除32的余数应当为0,4,8或16,最大值可取为65520。 |
返回值说明
无
流水类型
PIPE_MTE1
约束说明
通用约束
- 本接口非AIC调用直接返回。
- dst起始地址需512字节对齐(L0A Buffer对齐要求),否则会导致搬运异常。
- src起始地址需32字节对齐(L1 Buffer对齐要求),否则会导致搬运异常。
- 如果本指令与其他指令存在数据依赖,需要插入同步指令,保证多个指令串行化,防止出现异常数据。
- L0A Buffer容量上限:L0A Buffer总容量64KB,dst偏移量与搬运大小之和不可越界,否则触发异常。
- L1 Buffer容量上限:L1 Buffer总容量512KB,src偏移量与源矩阵占用大小之和不可越界,否则触发异常。
3D img2col搬运模式约束
- 此接口必须先调用asc_set_l13d_rpt接口配置dst_stride参数,dst_stride为输出矩阵在height维度对齐后的大小。
- 此接口需要先调用配套的寄存器设置接口asc_set_l13d_fmatrix与asc_set_l12l0a_3d_padding预先配置feature map描述、填充值与填充模式,否则会导致搬运接口不符合预期。如需使用repeat模式,须先调用asc_set_l13d_rpt接口配置repeat方向、次数与步长。
k_extension、m_extension或channel_size为0,filter_w为0且filter_size_w为false,或filter_h为0且filter_size_h为false时不执行搬运,本接口被视为NOP(空操作)。- 对于b32类型,
channel_size除8的余数应当为0或4,最大值可取为65532。对于b16类型,channel_size除16的余数应当为0,4或8,最大值可取为65528。对于b8类型,channel_size除32的余数应当为0,4,8或16,最大值可取为65520。否则会导致搬运结果不符合预期。 stride_w与stride_h不可为0,传入0硬件按1处理。stride_w取值范围为[1, 63],超出取值范围的值会被截断,导致搬运结果不符合预期。stride_h取值范围为[1, 63],超出取值范围的值会被截断,导致搬运结果不符合预期。
关键特性说明
3D img2col数据格式说明
要求输入的feature map和filter的格式是NC1HWC0,其中C0是最低维度而且C0是固定值为16(对于u8/s8类型为32),C1=C/C0。
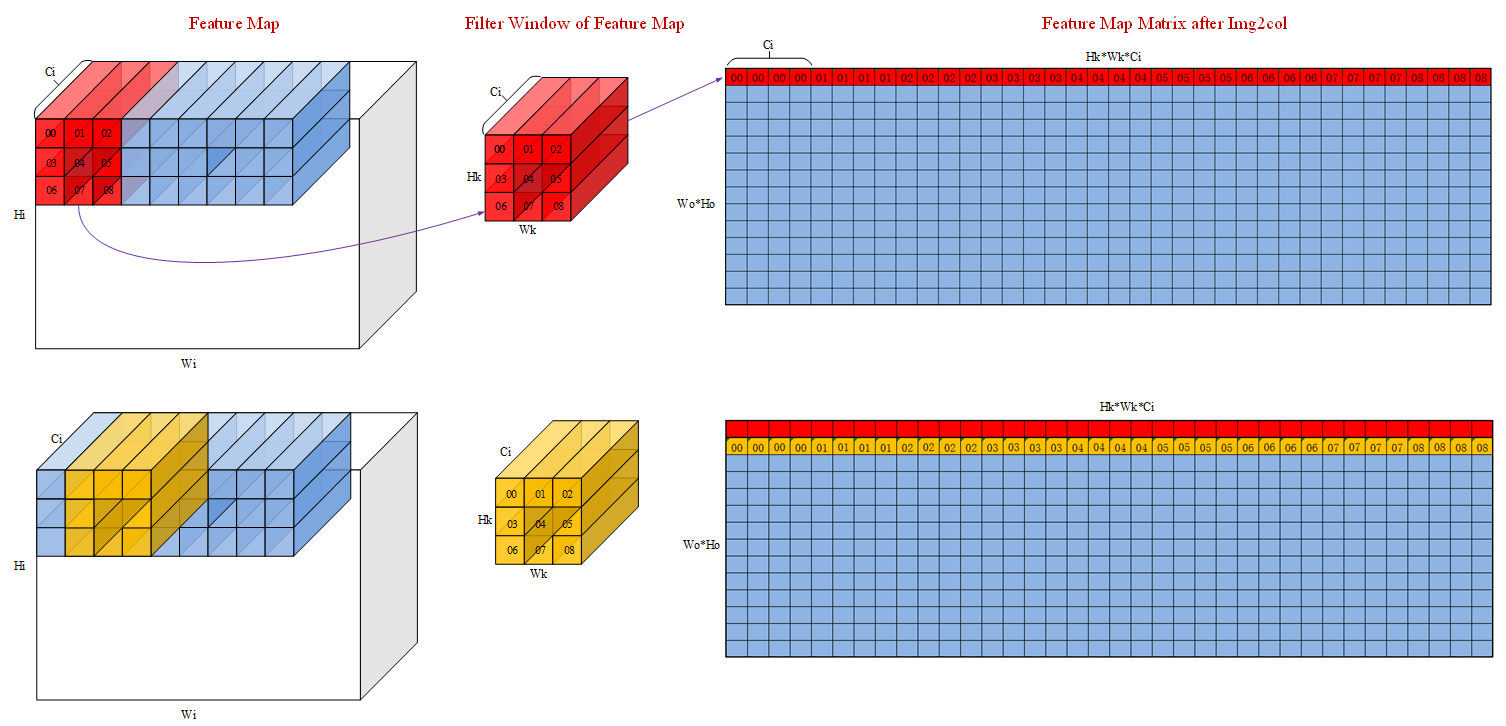
为了简化场景,以下场景假设输入的feature map的channel为4,即Ci=4。输入feature maps在L1 Buffer中的形状为(Hi,Wi,Ci),经过3D搬运处理后在L0A Buffer的数据形状为(Wo*Ho, Hk*Wk*Ci)。其中Wo和Ho是卷积后输出的shape,Hk和Wk是filter的shape。
直观的来看,img2col的过程就是filter在feature map上扫过,将对应feature map的数据展开成输出数据的每一行的过程。filter首先在W方向上滑动Wo步,然后在H方向上走一步然后重复以上过程,最终输出Wo * Ho行数据。下图中红色和黄色的数据分别代表第一行和第二行。数字表示原始输入数据,filter和输出数据三者之间的关联关系。可以看到,3D搬运处理首先在输入数据的Ci维度搬运对应于00的4个数,然后搬运对应于01的四个数,最终这一行的大小为Hk*Wk*Ci即3*3*4=36个数。
对应的feature map格式如下图:
图2 feature map格式
对应的filter的格式如下图:
图3 filter的格式
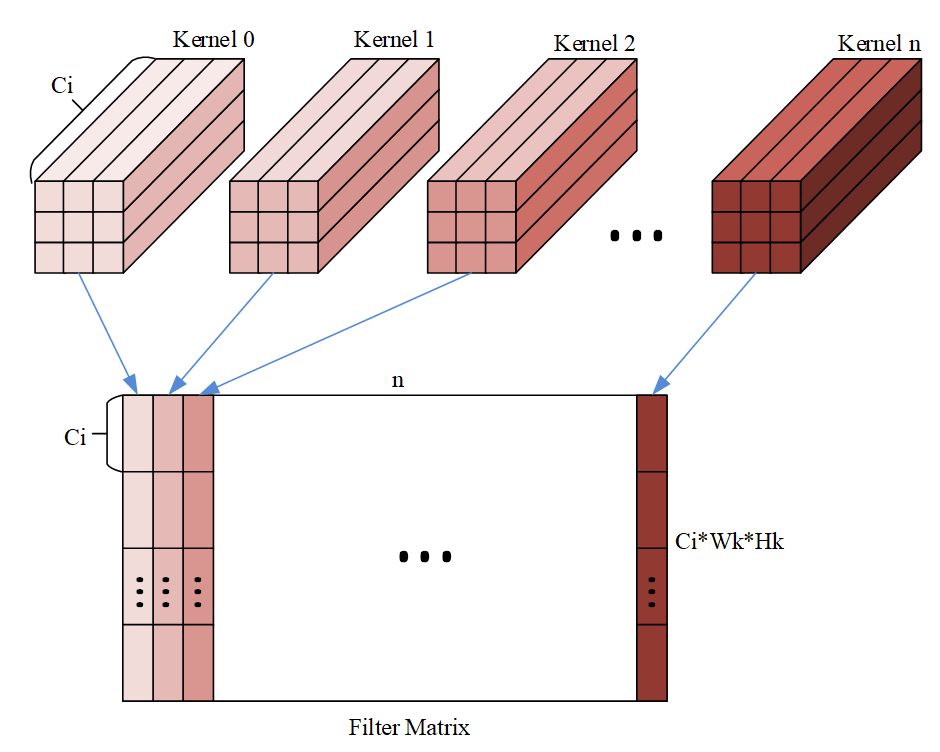
其中n为filter的个数,可以看出维度排布为(Hk,Wk,Ci,n),但是需要注意的是下图的格式还需要根据Mmad中B矩阵的格式转换。
图4 卷积计算分块
实际操作中,由于存储空间或者计算能力限制,我们通常会将整个卷积计算分块,一次只搬运并计算一小块数据。
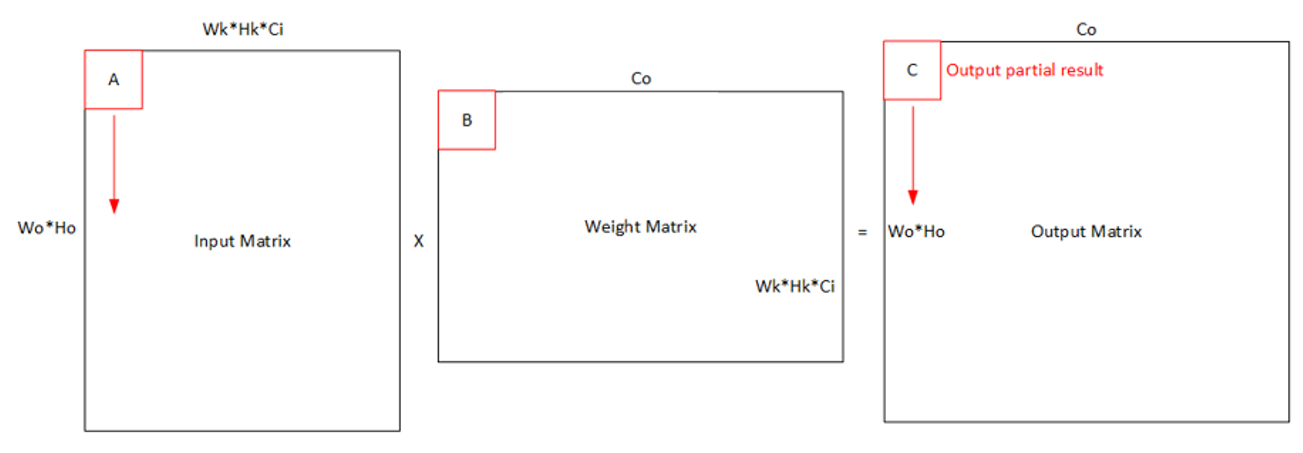
对于L0A Buffer中的feature map来说有两种方案,水平分块和垂直分块。分别对应asc_set_l13d_rpt参数中rpt_mode的0和1。
注:下图中的分形矩阵大小为4x4,实际应该为16x16 (对于u8/s8类型为16x32)
rpt_mode =0时,每次repeat会改变在filter窗口中读取数据点的位置,然后跳到下一个C0的位置。
图5 rpt_mode = 0时的filter窗口
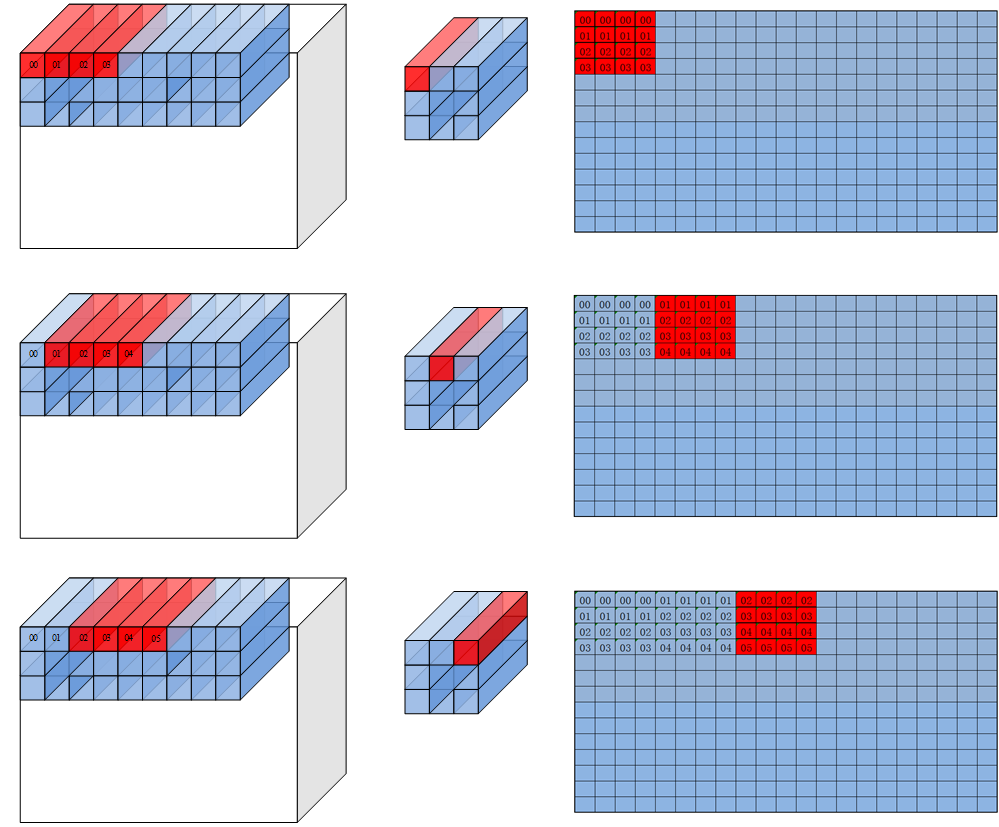
rpt_mode =1的时候filter窗口中读取数据的位置保持不变,每个repeat在feature map中前进C0个元素。
图6 rpt_mode = 1时的filter窗口
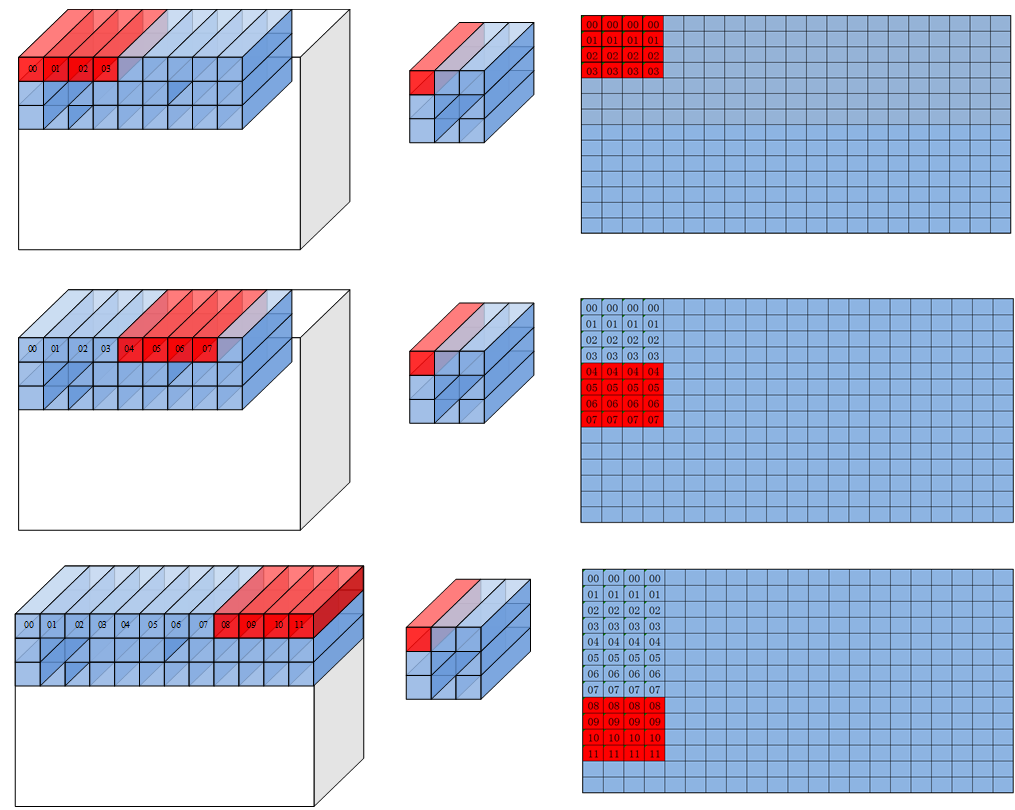
使用3D卷积数据搬运完成矩阵计算所需2D格式数据的搬运
对于NC1HWC0格式的数据,当N为1,卷积核width和height为1,padding为0,卷积核在源操作数width维度和height维度滑动的步长为1,卷积核width和height膨胀系数为1,此时经过image to column展开后的数据排布可以看成矩阵计算过程中L1 Buffer上的NZ分形排布,因此该场景下可以使用LoadData(卷积数据搬运)接口进行矩阵计算所需2D格式数据的搬运,示意图如下所示:

非转置场景搬运
L1 Buffer上的分形排布就是L0A Buffer中所需的Nz分形排布,3D卷积搬运不会进行分形排布转换,如下b16类型场景的示意图所示:

转置场景搬运
3D数据搬运在b8/b16/b32数据类型下均支持转置,L1 Buffer->L0A Buffer通路通过开启transpose参数开启转置,下面按照类型详细说明。
对于b8场景:每个分形大小是16×32。
L1 Buffer->L0A Buffer通路下,转置场景下,2个连续的16×32的分形拼接为一个32×32的方块矩阵,再进行转置并拆分为2个16×32的分形,转置示意图如下:

对于b16场景:每个分形大小是16×16。
L1 Buffer->L0A Buffer通路下,转置场景下,除了每个分形矩阵自身会被转置,每个分形矩阵在整个二维特征图中的位置也会被转置,转置示意图如下:

对于b32场景:每个分形大小是16×8。
L1 Buffer->L0A Buffer通路下,转置场景示意图如下:

Feature Map、Pad属性描述与Repeat Mode寄存器设置
Feature Map属性描述、Pad属性描述与Repeat Mode设置寄存器,作为Image to Column展开时的参数。当我们进行矩阵计算时,出于高性能搬运考虑,往往会从GM搬运大块数据到L1 Buffer,即在L1 Buffer中缓存一块较大的数据,然后通过for循环进行L1 Buffer->L0 Buffer的搬入并进行Mmad计算。当通过3D数据搬运接口进行L1 Buffer->L0 Buffer的搬入时,对于Feature Map属性、Pad属性与Repeat Mode参数我们通常只需要设置一次,不需要反复进行设置。
调用示例
将代码保存为examples.asc后,可通过bisheng命令编译运行,其中--npu-arch参数需根据实际产品型号指定对应的NPU架构,具体产品与NPU架构的映射关系请参考__NPU_ARCH__。
以Ascend 950PR&950DT系列产品(对应NPU架构为dav-3510)为例,编译运行命令如下:
bisheng examples.asc -o main --npu-arch=dav-3510 && ./main
#include <cmath>
#include <cstdint>
#include <iostream>
#include <vector>
#include "c_api/asc_simd.h"
#include "acl/acl.h"

namespace {
constexpr uint32_t BATCH = 4;
constexpr uint32_t C1 = 2;
constexpr uint32_t H = 9;
constexpr uint32_t W = 9;
constexpr uint32_t C0 = 16;
constexpr uint32_t CIN = C1 * C0;
constexpr uint32_t COUT = 16;
constexpr uint32_t KH = 3;
constexpr uint32_t KW = 3;
constexpr uint32_t STRIDE_H = 2;
constexpr uint32_t STRIDE_W = 2;
constexpr uint32_t DILATION_H = 2;
constexpr uint32_t DILATION_W = 2;
constexpr uint32_t PAD_LEFT = 2;
constexpr uint32_t PAD_RIGHT = 2;
constexpr uint32_t PAD_TOP = 2;
constexpr uint32_t PAD_BOTTOM = 2;
constexpr int32_t PAD_VALUE = 0;
constexpr uint32_t HOUT = 5;
constexpr uint32_t WOUT = 5;
constexpr uint32_t M = HOUT * WOUT;
constexpr uint32_t K = CIN * KH * KW;
constexpr uint32_t N = COUT;
constexpr uint32_t CUBE_BLOCK = 16;
constexpr uint32_t M_ALIGN = 32;
constexpr uint32_t K_ALIGN = 288;
constexpr uint32_t N_ALIGN = 16;
constexpr uint32_t FMAP_BATCH_SIZE = H * W * CIN;
constexpr uint32_t WEIGHT_SIZE = K * COUT;
constexpr uint32_t OUTPUT_BATCH_SIZE = HOUT * WOUT * COUT;
constexpr uint32_t FRACTAL_ELEMENTS = 512 / sizeof(half);
constexpr uint32_t LOAD3D_K_EXTENSION = K_ALIGN;

__global__ __cube__ void Conv2dForwardCapi(
    __gm__ half* fmap, __gm__ half* weight, __gm__ half* output)
{
    asc_init();
    const uint32_t batch_idx = static_cast<uint32_t>(block_idx);
    if (batch_idx >= BATCH) {
        return;
    }

    __cbuf__ half fmap_l1[FMAP_BATCH_SIZE];
    __cbuf__ half weight_l1[K_ALIGN * N_ALIGN];
    __ca__ half fmap_l0[M_ALIGN * K_ALIGN];
    __cb__ half weight_l0[K_ALIGN * N_ALIGN];
    __cc__ float output_l0[M_ALIGN * N_ALIGN];

    asc_set_gm2l1_nz_para(1, 1, H * W, 0);
    asc_copy_gm2l1_nd2nz(
        fmap_l1, fmap + batch_idx * FMAP_BATCH_SIZE, CIN * sizeof(half), asc_load_l2_cache_mode::NORMAL_FIRST_VICTIM,
        H * W, CIN, 0, false);

    asc_set_gm2l1_nz_para(1, 1, K_ALIGN, 0);
    asc_copy_gm2l1_nd2nz(weight_l1, weight, COUT * sizeof(half), asc_load_l2_cache_mode::NORMAL_FIRST_VICTIM, K, COUT, 0, false);
    asc_sync_notify(PIPE_MTE2, PIPE_MTE1, EVENT_ID0);
    asc_sync_wait(PIPE_MTE2, PIPE_MTE1, EVENT_ID0);

    asc_l13d_fmatrix_config fmatrix_config;
    fmatrix_config.l1_width = W;
    fmatrix_config.l1_height = H;
    fmatrix_config.padding_left_size = PAD_LEFT;
    fmatrix_config.padding_right_size = PAD_RIGHT;
    fmatrix_config.padding_top_size = PAD_TOP;
    fmatrix_config.padding_bottom_size = PAD_BOTTOM;
    asc_set_l13d_fmatrix(fmatrix_config);
    asc_set_l12l0a_3d_padding(static_cast<half>(PAD_VALUE));
    constexpr uint16_t repeat_stride = 0;
    constexpr uint8_t repeat_time = 1;
    constexpr uint8_t repeat_mode = 0;
    constexpr uint16_t dst_stride = M_ALIGN / CUBE_BLOCK;
    asc_load3d_v2_config repeat_config;
    // SetLoadDataRepeatWithStride encodes dstStride in bits [47:32].
    repeat_config.config = static_cast<uint64_t>(repeat_stride) |
        (static_cast<uint64_t>(repeat_time) << 16) |
        (static_cast<uint64_t>(repeat_mode) << 24) |
        (static_cast<uint64_t>(dst_stride) << 32);
    asc_set_l13d_rpt(repeat_config);
    asc_copy_l12l0a(
        fmap_l0, fmap_l1, LOAD3D_K_EXTENSION, M, 0, 0, STRIDE_W, STRIDE_H, KW, KH, DILATION_W, DILATION_H,
        false, false, false, false, CIN);

    for (uint16_t i = 0; i < K_ALIGN / CUBE_BLOCK; ++i) {
        asc_copy_l12l0b_transpose(weight_l0 + i * FRACTAL_ELEMENTS, weight_l1, 0, i, 1, 1, 1, 1);
    }
    asc_sync_notify(PIPE_MTE1, PIPE_M, EVENT_ID0);
    asc_sync_wait(PIPE_MTE1, PIPE_M, EVENT_ID0);

    asc_mmad(output_l0, fmap_l0, weight_l0, M, K_ALIGN, N, asc_unit_flag_mode::DISABLE, false, false, true);
    asc_sync_notify(PIPE_M, PIPE_FIX, EVENT_ID0);
    asc_sync_wait(PIPE_M, PIPE_FIX, EVENT_ID0);

    asc_set_l0c_copy_nz_para(1, 0, 0);
    asc_copy_l0c2gm(
        output + batch_idx * OUTPUT_BATCH_SIZE, output_l0, N, M, N, M_ALIGN,
        asc_store_l2_cache_mode::NORMAL_FIRST_VICTIM, asc_unit_flag_mode::DISABLE, QuantMode_t::F322F16,
        asc_relu_pre_mode::NONE, false, true, false, false);
    asc_sync_pipe(PIPE_FIX);
}

size_t FmapIndex(uint32_t n, uint32_t h, uint32_t w, uint32_t c)
{
    return ((n * H + h) * W + w) * CIN + c;
}

size_t WeightIndex(uint32_t c1, uint32_t kh, uint32_t kw, uint32_t c0, uint32_t co)
{
    const uint32_t k = ((c1 * KH + kh) * KW + kw) * C0 + c0;
    return k * COUT + co;
}

std::vector<half> MakeGolden(const std::vector<half>& fmap, const std::vector<half>& weight)
{
    std::vector<half> golden(BATCH * OUTPUT_BATCH_SIZE);
    for (uint32_t n = 0; n < BATCH; ++n) {
        for (uint32_t ho = 0; ho < HOUT; ++ho) {
            for (uint32_t wo = 0; wo < WOUT; ++wo) {
                for (uint32_t co = 0; co < COUT; ++co) {
                    float acc = 0.0f;
                    for (uint32_t c1 = 0; c1 < C1; ++c1) {
                        for (uint32_t kh = 0; kh < KH; ++kh) {
                            for (uint32_t kw = 0; kw < KW; ++kw) {
                                const int32_t hi = static_cast<int32_t>(ho * STRIDE_H + kh * DILATION_H) - PAD_TOP;
                                const int32_t wi = static_cast<int32_t>(wo * STRIDE_W + kw * DILATION_W) - PAD_LEFT;
                                for (uint32_t c0 = 0; c0 < C0; ++c0) {
                                    const uint32_t ci = c1 * C0 + c0;
                                    const float x = hi < 0 || hi >= static_cast<int32_t>(H) || wi < 0 ||
                                            wi >= static_cast<int32_t>(W)
                                        ? static_cast<float>(PAD_VALUE)
                                        : static_cast<float>(fmap[FmapIndex(n, hi, wi, ci)]);
                                    acc += x * static_cast<float>(weight[WeightIndex(c1, kh, kw, c0, co)]);
                                }
                            }
                        }
                    }
                    golden[((n * HOUT + ho) * WOUT + wo) * COUT + co] = static_cast<half>(acc);
                }
            }
        }
    }
    return golden;
}
} // namespace

int main()
{
    std::vector<half> fmap(BATCH * FMAP_BATCH_SIZE);
    std::vector<half> weight(WEIGHT_SIZE);
    std::vector<half> output(BATCH * OUTPUT_BATCH_SIZE);
    for (size_t i = 0; i < fmap.size(); ++i) {
        fmap[i] = static_cast<half>(static_cast<int32_t>(i % 5) - 2);
    }
    for (uint32_t c1 = 0; c1 < C1; ++c1) {
        for (uint32_t kh = 0; kh < KH; ++kh) {
            for (uint32_t kw = 0; kw < KW; ++kw) {
                for (uint32_t c0 = 0; c0 < C0; ++c0) {
                    for (uint32_t co = 0; co < COUT; ++co) {
                        weight[WeightIndex(c1, kh, kw, c0, co)] =
                            static_cast<half>(static_cast<int32_t>((c1 + kh + 2 * kw + c0 + co) % 3) - 1);
                    }
                }
            }
        }
    }
    const std::vector<half> golden = MakeGolden(fmap, weight);

    half *fmap_device = nullptr, *weight_device = nullptr, *output_device = nullptr;
    aclInit(nullptr);
    aclrtSetDevice(0);
    aclrtMalloc(reinterpret_cast<void**>(&fmap_device), fmap.size() * sizeof(half), ACL_MEM_MALLOC_HUGE_FIRST);
    aclrtMalloc(reinterpret_cast<void**>(&weight_device), weight.size() * sizeof(half), ACL_MEM_MALLOC_HUGE_FIRST);
    aclrtMalloc(reinterpret_cast<void**>(&output_device), output.size() * sizeof(half), ACL_MEM_MALLOC_HUGE_FIRST);
    aclrtMemcpy(fmap_device, fmap.size() * sizeof(half), fmap.data(), fmap.size() * sizeof(half), ACL_MEMCPY_HOST_TO_DEVICE);
    aclrtMemcpy(weight_device, weight.size() * sizeof(half), weight.data(), weight.size() * sizeof(half), ACL_MEMCPY_HOST_TO_DEVICE);
    Conv2dForwardCapi<<<BATCH, 0>>>(fmap_device, weight_device, output_device);
    aclrtSynchronizeDevice();
    aclrtMemcpy(output.data(), output.size() * sizeof(half), output_device, output.size() * sizeof(half), ACL_MEMCPY_DEVICE_TO_HOST);

    size_t mismatch_count = 0;
    float max_diff = 0.0f;
    for (size_t i = 0; i < output.size(); ++i) {
        const float diff = std::fabs(static_cast<float>(output[i]) - static_cast<float>(golden[i]));
        max_diff = diff > max_diff ? diff : max_diff;
        mismatch_count += diff > 1e-3f;
    }
    std::cout << "Example 1: max diff=" << max_diff
              << ", mismatches=" << mismatch_count << '/' << output.size() << std::endl;
    std::cout << (mismatch_count == 0 ? "[Success] conv2d_forward C API passed."
                                     : "[Failed] conv2d_forward C API mismatch.") << std::endl;

    aclrtFree(fmap_device);
    aclrtFree(weight_device);
    aclrtFree(output_device);
    aclrtResetDevice(0);
    aclFinalize();
    return mismatch_count == 0 ? 0 : 1;
}